SpaceXAI випустила нову модель Grok 4.7, яку компанія позиціонує як інструмент для програмування, обробки знань та виконання завдань, що можуть розтягуватися на кілька годин. В основі — більша базова модель порівняно з Grok 4.6, а також довший цикл навчання з підкріпленням.
За словами розробників, оновлена версія краще утримує довгий контекст, ретельніше перевіряє власні результати та оптимізована для роботи в середовищі Grok Build. Користуватися моделлю можна через Cursor, Grok Build, API та ряд сторонніх сервісів.
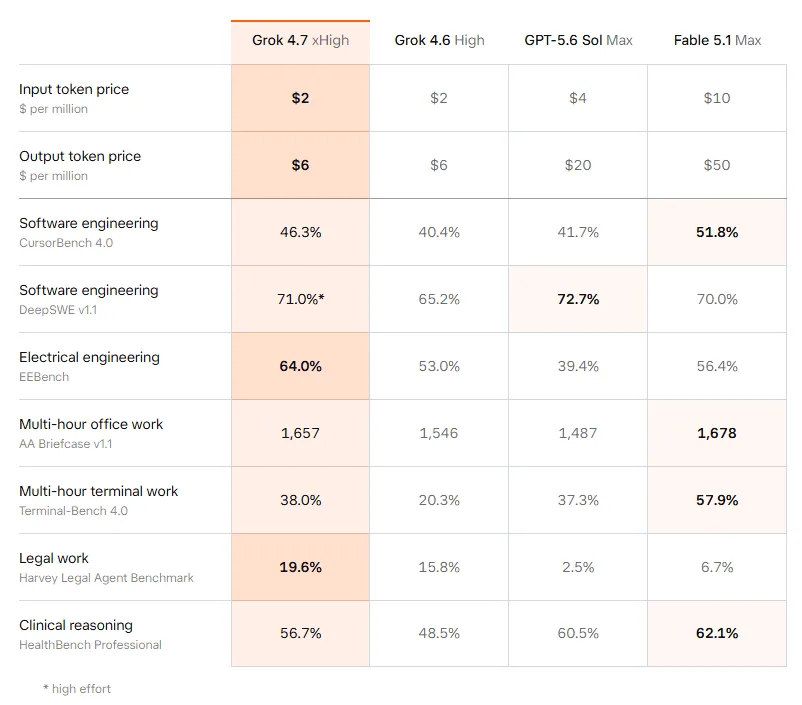
Ціна доступу становить $2 за мільйон вхідних токенів і $6 за мільйон вихідних. Прискорена версія Fast обробляє запити вдвічі швидше, але й коштує вдвічі більше.
Результати тестів і порівняння з конкурентами
Згідно з даними, які опублікувала сама SpaceXAI, Grok 4.7 суттєво покращила показники порівняно з попередньою версією. У тесті CursorBench 4.0 модель отримала 46,3% — це більше за 40,4% у Grok 4.6. GPT-5.6 Sol у цьому тесті показав 41,7%, а лідером стала Fable 5.1 із результатом 51,8%. У бенчмарку DeepSWE v1.1 три моделі набрали відповідно 71%, 72,7% та 70%.
У завданнях, пов'язаних із роботою в терміналі, Grok 4.7 продемонструвала 38% проти 20,3% у попередника та 37,3% у GPT-5.6 Sol. Проте Fable 5.1 вирвалася далеко вперед із показником 57,9%. У тесті EEBench, орієнтованому на електротехнічні завдання, Grok показала 64%, обійшовши обох згаданих конкурентів. А от у HealthBench Professional вона поступилася їм обом.
Одна з переваг нової моделі — ціна. За даними SpaceXAI, GPT-5.6 Sol коштує $4 за вхідні та $20 за вихідні токени (за мільйон), а Fable 5.1 — $10 і $50 відповідно. Тобто дешевша вартість Grok не гарантує першості в усіх тестах, але робить її вигіднішою для задач із великим обсягом обчислень.
Розробники окремо наголосили на посиленні захисних механізмів моделі, заявивши про повне оновлення системи безпеки.
У внутрішньому тесті HackerBench v0.3 модель пропустила 3,3% запитів, віднесених компанією до потенційно небезпечних сценаріїв подвійного призначення. При цьому в SpaceXAI стверджують, що система намагається не заважати легітимній роботі фахівців з кібербезпеки.
Частина партнерів отримала доступ до Grok 4.7 для закритого тестування методом red teaming. Ці дані наразі опубліковані лише самою компанією й не пройшли незалежної перевірки.
Оцінки незалежних експертів
Платформа Artificial Analysis повідомила в X, що за її Intelligence Index Grok 4.7 отримала 46 балів — на два бали більше за Grok 4.6. Найбільший прогрес аналітики зафіксували саме в довгих агентних завданнях: у Coding Agent Index пара Grok 4.7 та Grok Build здобула 56 балів проти 47 у попередній версії.
Водночас експерти відзначили зростання витрат обчислювальних ресурсів. У режимі xhigh модель витрачала близько 81 000 вихідних токенів на одне завдання Intelligence Index — більш ніж удвічі більше порівняно з попередньою версією в аналогічному режимі. В Artificial Analysis вважають, що головні поліпшення стосуються саме агентних сценаріїв, тоді як в інших видах тестів прогрес незначний.
Платформа Vals AI отримала менш переконливі результати. У її тестовому наборі Grok 4.7 набрала 54,2% і зайняла 24-ту позицію, тоді як Grok 4.6 мала 59,2% і 14-те місце. Найбільше покращення експерти зафіксували в юридичних та медичних завданнях. Розбіжність із даними Artificial Analysis демонструє, наскільки оцінка моделі залежить від обраної методології та набору тестових сценаріїв.
Компанія XBOW, що займається розробкою ШІ для кібербезпеки, теж отримала ранній доступ до Grok 4.7 і протестувала її на завданнях offensive security. Результати виявились неоднозначними: у стандартному середовищі модель у деяких випадках показувала гірші результати за Grok 4.6 і потребувала більшої кількості спроб для розв'язання завдань.
Ситуація змінилась, коли тести проводили через Grok Build. В одному з наборів завдань кількість правильно виявлених проблем зросла з 42 у Grok 4.6 до 68 у Grok 4.7.
У XBOW зробили висновок, що ключова перевага нової версії — не в розв'язанні принципово нових типів завдань, а в ефективнішій взаємодії з агентною інфраструктурою. При цьому за загальною якістю в offensive security фахівці компанії поки ставлять Grok 4.7 нижче за найпотужніші з протестованих ними систем.
Загалом перші незалежні оцінки свідчать про помітне зростання можливостей Grok у тривалих агентних завданнях і програмуванні. Водночас результати тестів показують, що переваги нової версії не є абсолютними — вони залежать від конкретного інструментарію, рівня складності міркувань та типу навантаження.