Стартап Tavus оприлюднив Griffin — розробку, яку відносить до нового класу Human Interaction Model (HIM). Ця система здатна водночас аналізувати зображення, звук і мову співрозмовника, а також миттєво реагувати на його жести чи міміку. У компанії наголошують, що саме Griffin стала першою моделлю, яка витримала відеоверсію тесту Тюрінга.
У межах випробування хвилинну відеобесіду з Griffin провели учасники, і 48% з них були впевнені, що спілкуються зі справжньою людиною. Для порівняння: попередня розробка Tavus показала результат лише 2,4%.
https://x.com/tavus/status/2105704169009246248?ref_src=twsrc%5Etfw
Наразі доступ до Griffin мають тільки окремі тестувальники в межах дослідницького прев'ю. У Tavus пояснюють, що перед повноцінним запуском потрібно закрити низку питань, пов'язаних із безпекою, адже вміння моделі видавати себе за людину несе додаткові загрози.
Griffin одночасно бачить, слухає та реагує
В основі Griffin лежить повнодуплексна архітектура video-to-video. На відміну від каскадних рішень, що спершу розпізнають мовлення, далі формують відповідь і лише потім озвучують її, Griffin ухвалює рішення в межах коротких, менше секунди, інтервалів.
- реагувати на паузи, погляд, міміку та жести співрозмовника
- переривати або підтримувати діалог, не випускаючи з уваги контекст
- слухати та говорити паралельно
- розпізнавати предмети й оточення та враховувати їх у відповіді
- змінювати тон голосу, вираз обличчя та жести залежно від ситуації
- оцінювати тривалість паузи й самостійно обирати момент для репліки
Tavus показала ці можливості на прикладах. Griffin брала участь у грі Simon Says, одночасно стежачи і за словами, і за рухами гравців. В іншій демонстрації модель органічно вписала в розмову павича, якого показали в камеру. Крім того, вона допомагала складати кубик Рубіка, відстежуючи рухи рук, а також супроводжувала роботу з паяльником, контролюючи час виконання.
Архітектура Griffin складається з двох частин: Continuous Conversational Modeling відповідає за аналіз аудіо та відео й вирішує, коли і як реагувати, а Audio-Visual Generation перетворює ці дані на мовлення й зображення.
За інформацією Tavus, версія Griffin-Lite генерує відео в роздільній здатності 720p фрагментами по 320 мс у реальному часі. На чипах H100 середня затримка склала 0,43 секунди — удвічі менше за найближчого конкурента в тестуванні.
Griffin випередила інші моделі в тестах NVIDIA
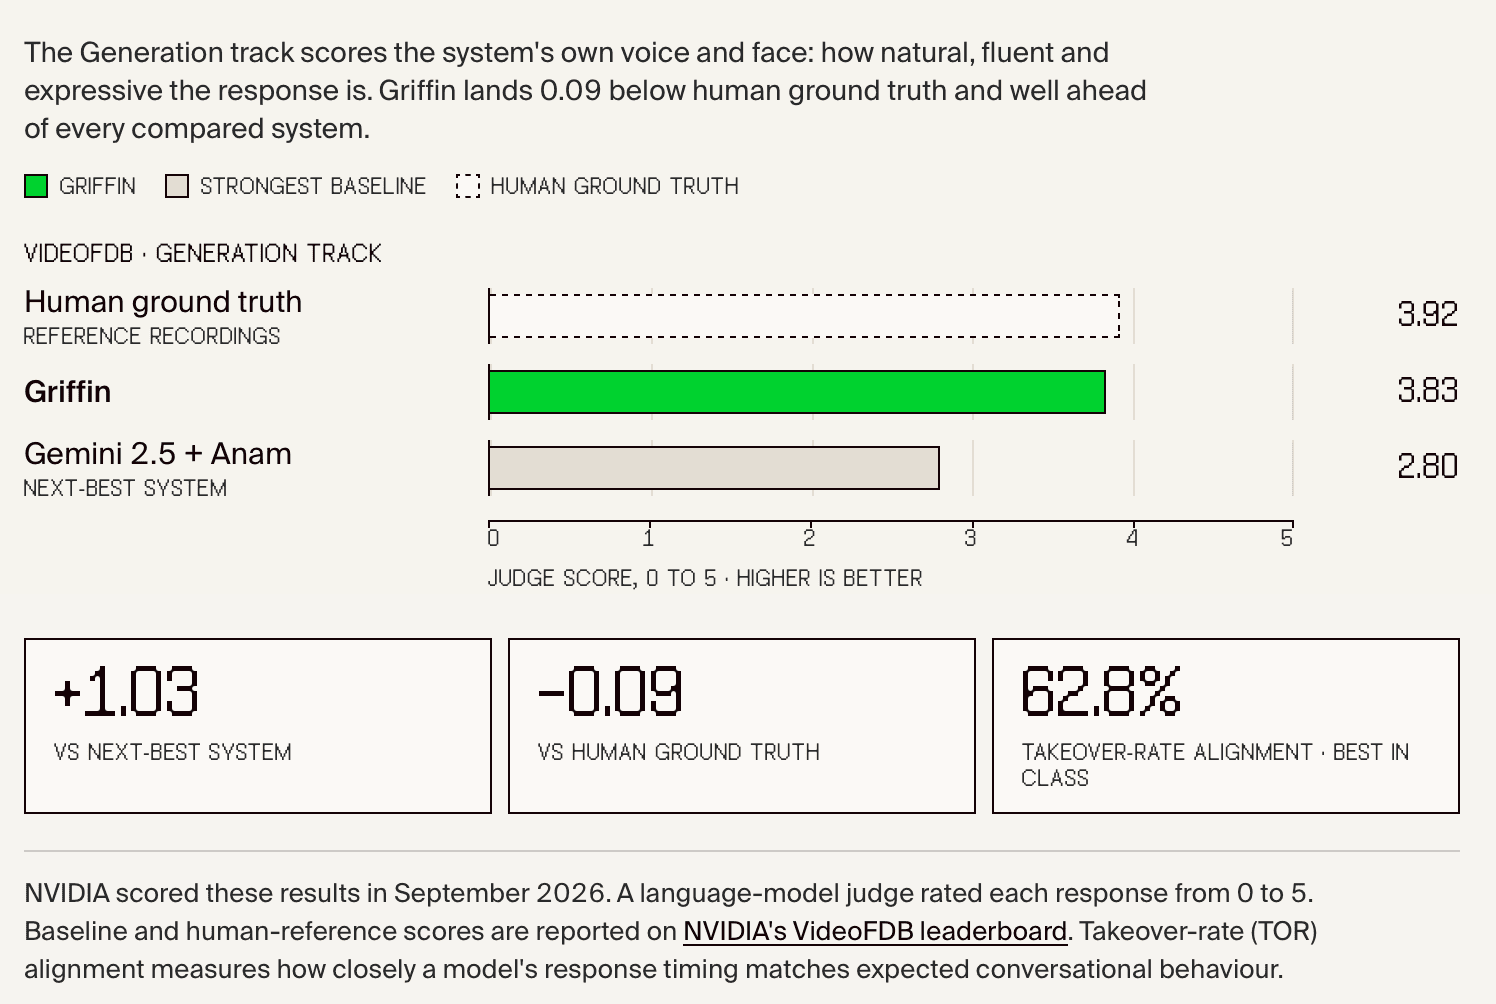
У незалежному бенчмарку NVIDIA VideoFDB, створеному для оцінки повнодуплексної аудіовізуальної взаємодії, Griffin-Lite вийшла на перше місце серед 15 перевірених моделей.
У категорії генерації модель набрала 3,83 бала проти 3,92 у людини-еталона, а в категорії сприйняття — 3,73 бала. Також Griffin продемонструвала найкращу точність визначення моменту для початку репліки: 62,8% у генерації та 73,8% у сприйнятті.
Найяскравіший результат показав тест за участю 54 людей: після хвилинної відеобесіди 26 із них, тобто 48%, назвали свого співрозмовника реальною людиною. Для попередньої системи Phoenix-4.5 у зв'язці зі Sparrow-2 та Raven-1 цей показник дорівнював 2,4% — лише один учасник з 41.
Понад половина тих, хто спілкувався з Griffin-Lite, взагалі не припускали, що розмовляють зі штучним інтелектом. А ті, хто запідозрив підміну, зазвичай робили це в перші 20 секунд розмови.
Саме завдяки здатності настільки переконливо імітувати живу людину доступ до Griffin поки обмежений. У Tavus повідомили, що компанія розробляє механізми для безпечного розкриття того, що співрозмовник — штучний інтелект, а також додаткові процедури оцінки ризиків.
Ті самі властивості, які роблять Human Interaction Models потужними інтерфейсами для природної комунікації між людиною та машиною, дозволяють їм обманом змусити людину повірити, що перед нею не ШІ.
розробники Tavus
Tavus має намір випустити більш потужну версію Griffin для ширшої аудиторії, щойно питання безпеки будуть розв'язані.